

回到门户首页,我们观察“常用下载”这一模块。浏览器为什么知道哪里该放大标题,哪里该排出一列带下划线的链接?
答案藏在服务器发送给浏览器的原始数据里。Web 服务器传给浏览器的并不是一张已经渲染好的图片,而是一份带有结构标记的纯文本,即 HTML(超文本标记语言)。浏览器读取并解析这些标记,才知道哪些文字应作为标题、哪些应作为段落、哪些是超链接,最终把页面排版出来。
查看网页源代码
在首页空白处单击鼠标右键,在弹出的菜单中选择 “查看网页源代码”(View Page Source)。浏览器会打开一个新的标签页,里面展示的就是服务器返回的原始 HTML 代码。
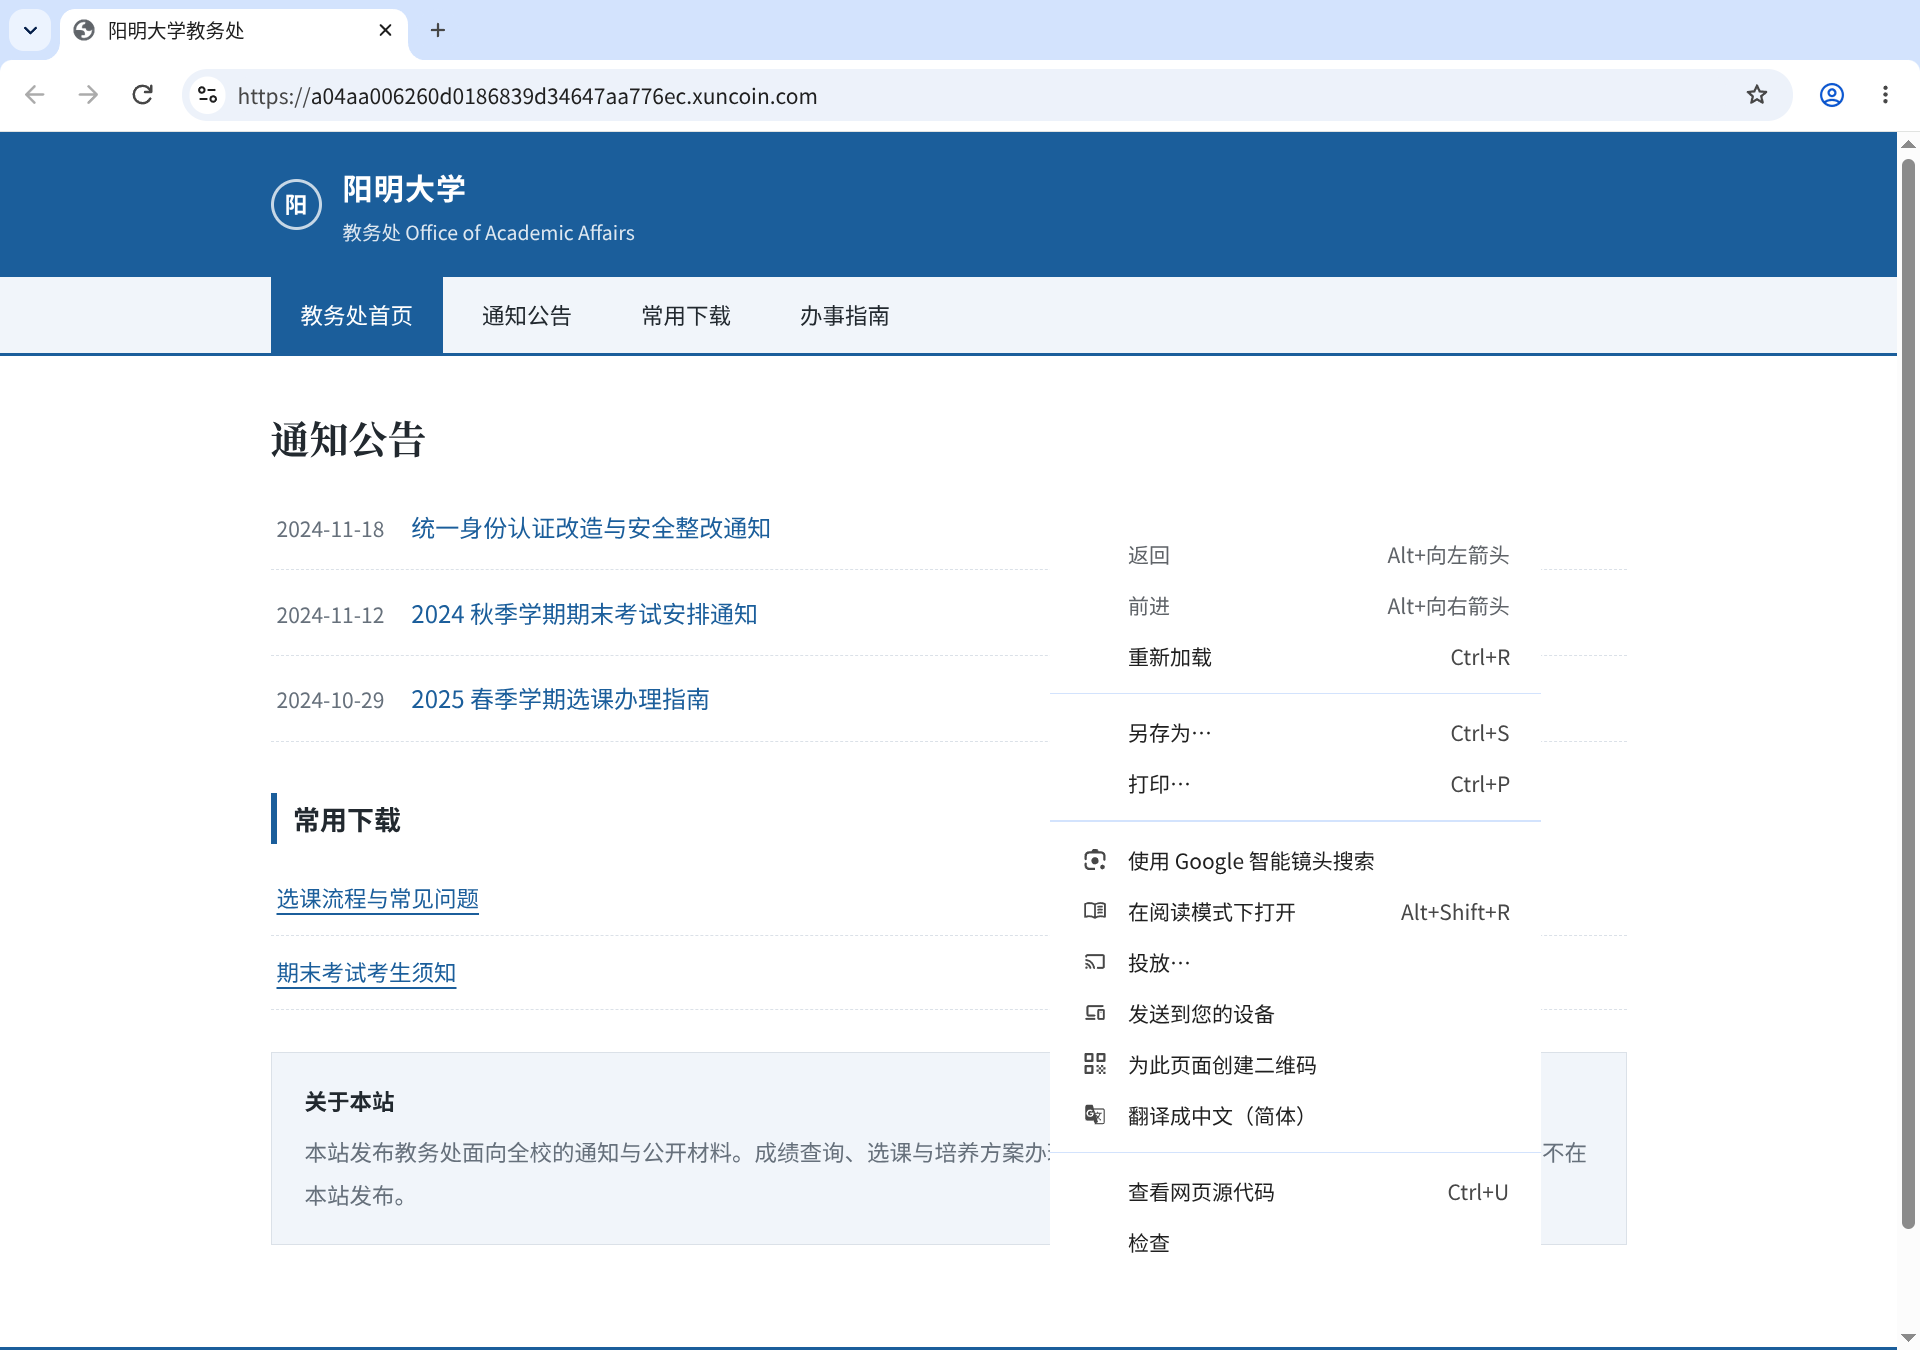
在桌面端浏览器中,也可以直接在当前网址前加上 view-source: 前缀,并在新标签页打开:
正常页面:https://你的实验站地址/
源码视图:view-source:https://你的实验站地址/
进入源码视图后,按下快捷键 Ctrl+F(Mac 上为 Cmd+F)唤出搜索框,输入关键词 常用下载 进行定位。优先搜索页面上已经看到的中文文本,能帮助我们更快在冗长源码中找到目标代码段。
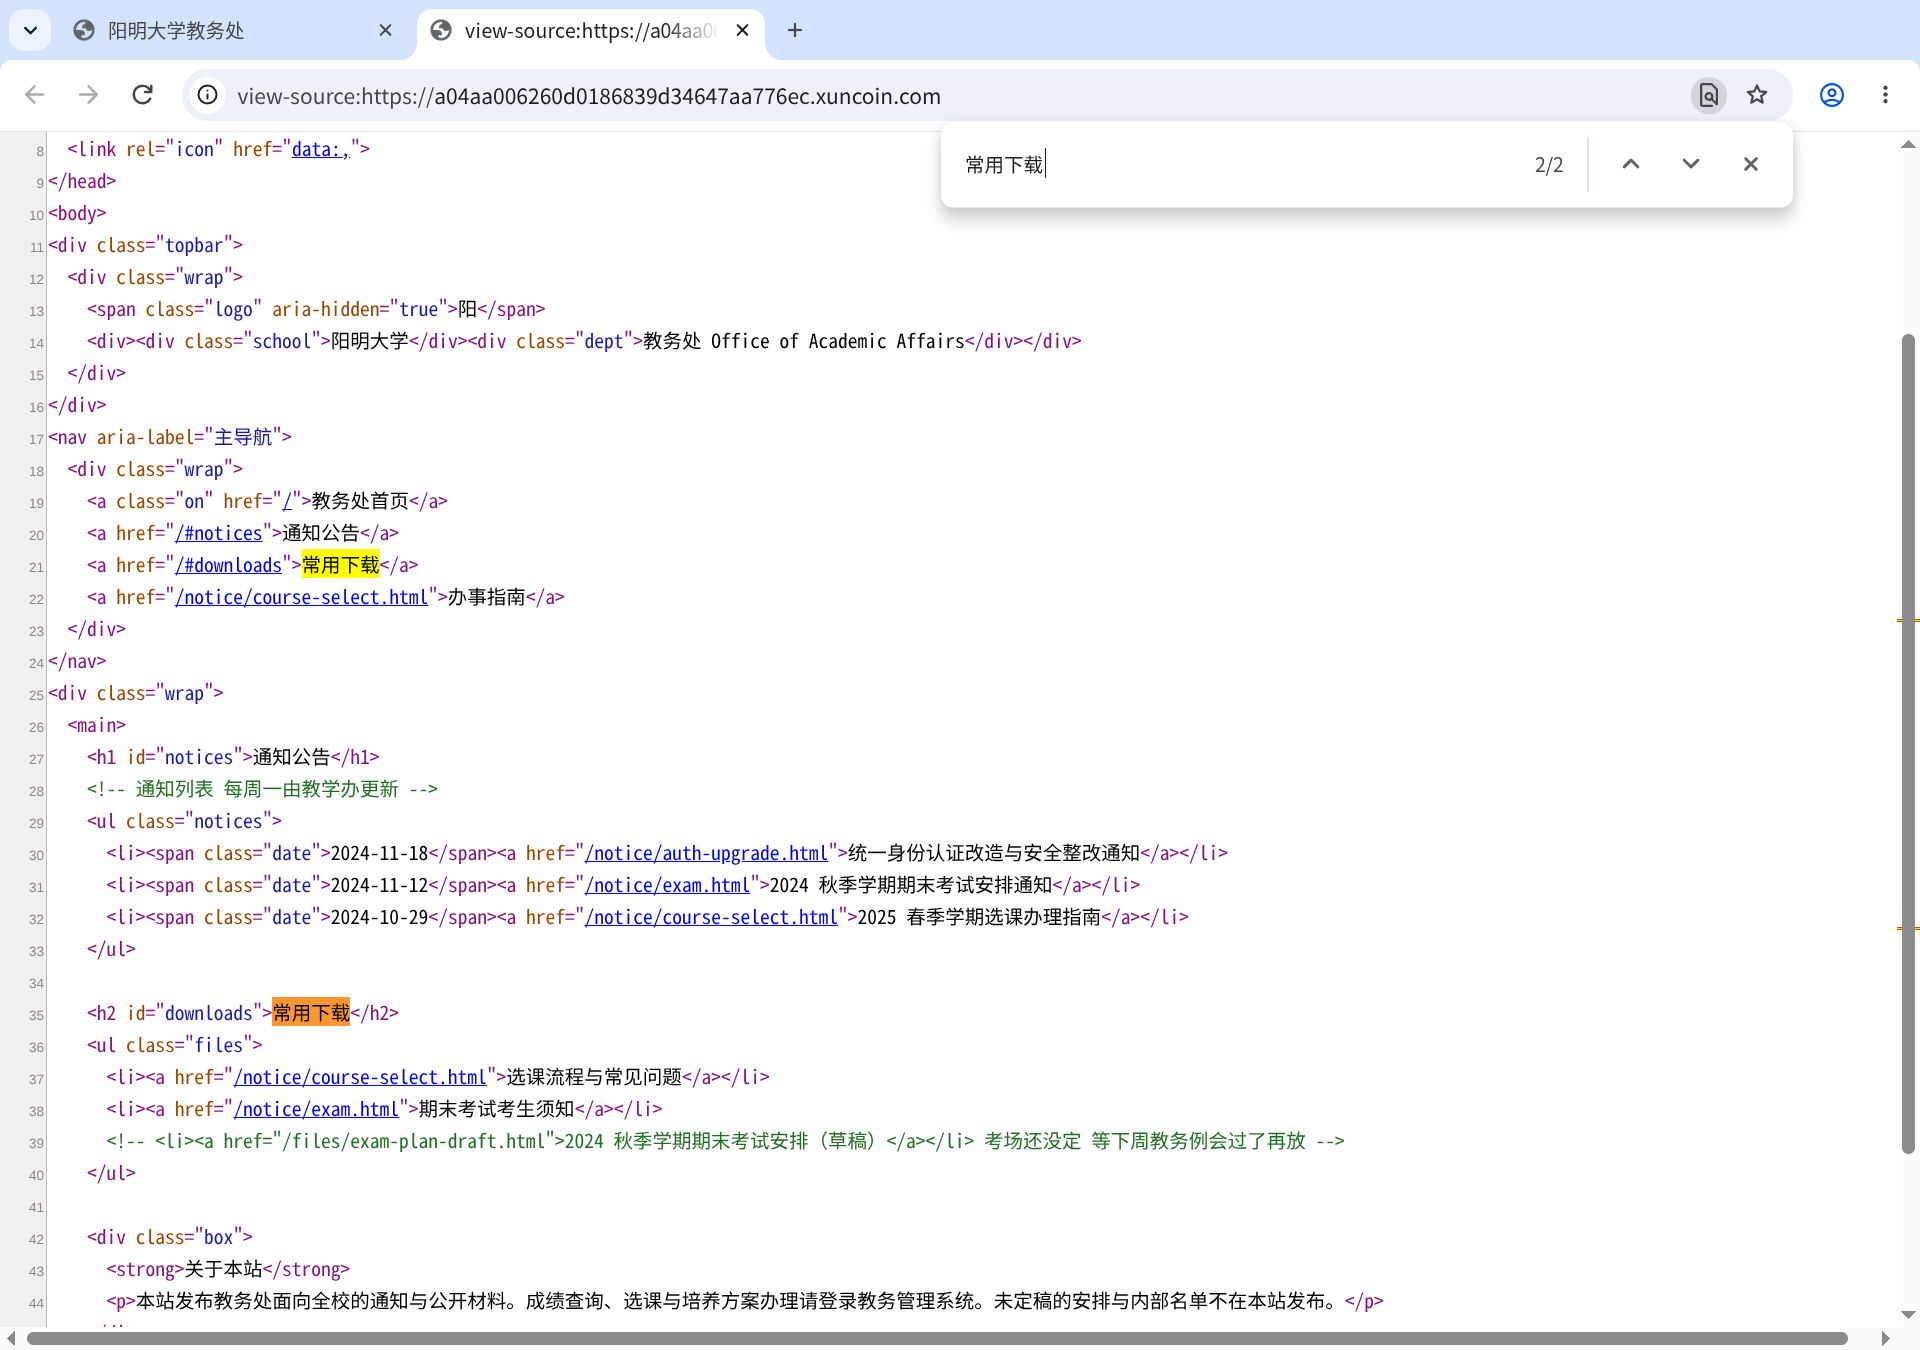
我们定位到了下面这段核心 HTML:
<h2 id="downloads">常用下载</h2>
<li><a href="/notice/course-select.html">选课流程与常见问题</a></li>
其中,<h2> 和 </h2> 是二级标题标签,用来告诉浏览器:把它们之间的文字渲染成较大、较粗的标题。<a> 是超链接标签,里面的 href 属性定义了点击链接后跳转的目标路径,也就是选课指南位于 /notice/course-select.html。id="downloads" 则是给这个元素设置的一个唯一标识符。
对比页面和源码视图,可以看到一个明显区别:普通页面只展示最终结果,尖括号里的标记语法都被浏览器解析并隐藏了;而源码视图保留的是未经加工的原始指令,我们可以直接查看这些标记。
HTML 注释中的隐藏信息
在刚才那段代码的上方,紧挨着通知列表的位置,有一行格式特殊的代码:
<!-- 通知列表 每周一由教学办更新 -->
这是标准的 HTML 注释,以 <!-- 开头,以 --> 结尾。开发者通常会用它在源代码里留下备忘、提醒或协作说明。浏览器在渲染网页时会按照 HTML 规范忽略注释内容,因此它不会显示在页面正文中。
仔细体会这里的技术逻辑:既然我们能在源码视图中看到这行注释,就说明 Web 服务器已经把这段文本完整地传输给了浏览器。它没有出现在页面上,只是因为浏览器按照 HTML 规则跳过了它的渲染。换句话说,只要用户能够访问这个网站,通过查看源码就可能看到这些隐藏内容。
虽然“每周一由教学办更新”只是一句普通的工作备忘,但它揭示了一个重要常识:服务器发送给浏览器的数据,往往比页面表面显示出来的内容更多。