
HTML 说白了就是一个带标签语法的纯文本文件。我们先在自己电脑上写一个最短的网页,看看浏览器是怎么把它变成画面的,顺便看看在浏览器里直接改页面会发生什么。
写一个本地网页
打开任意纯文本编辑器(记事本、VS Code 等),新建文件写入下面 6 行内容,以 UTF-8 编码保存为 notes.html(注意扩展名是 .html,不是 .html.txt):
<!doctype html>
<html lang="zh-CN">
<meta charset="utf-8">
<title>我的笔记</title>
<h1>学习笔记</h1>
<p>今天认识程序与文件。</p>
双击 notes.html 用浏览器打开。浏览器并没有把 <h1>、<p> 这些尖括号原样印出来,而是把它们解析成了大号加粗标题“学习笔记”和一段正文,顶部标签页上则显示 <title> 里的“我的笔记”:
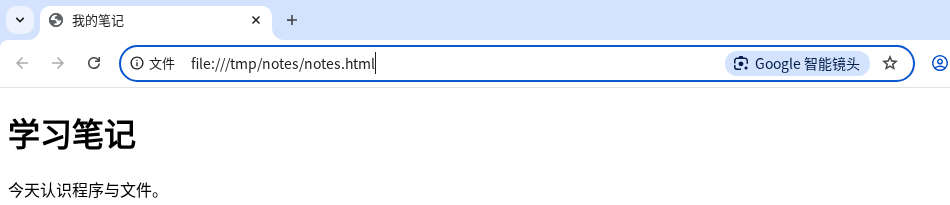
看一眼浏览器地址栏,开头是 file:///...。这说明浏览器只是直接从你电脑硬盘上读了这个文件,全程没有联网,也没有任何 Web 服务器参与。
用 F12 改页面,为什么一刷新就没了?
在页面的“学习笔记”标题上点右键,选“检查(Inspect)”(或者直接按 F12),打开浏览器的开发者工具(DevTools)。
在默认的 Elements(元素) 面板里,可以看到浏览器当前在内存里维护的页面结构。找到 <h1>学习笔记</h1> 这一行,双击里面的“学习笔记”,改成“浏览器里的修改”并按回车:
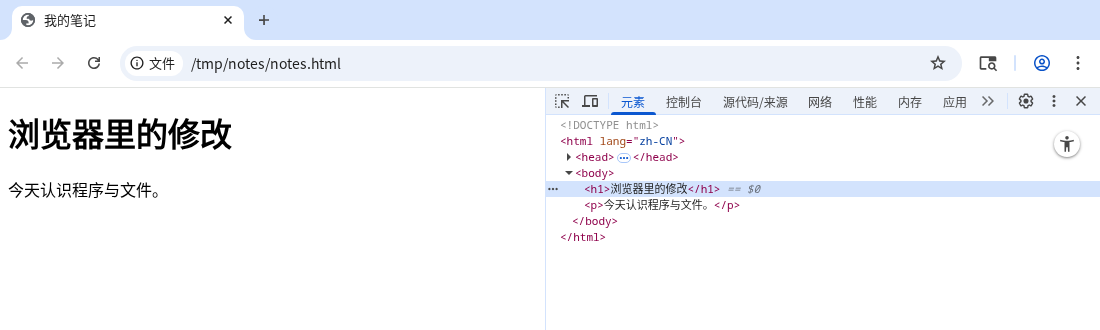
网页上的大标题当场就跟着变成了“浏览器里的修改”。但只要你按一下浏览器的刷新按钮(F5),标题马上又变回了“学习笔记”:
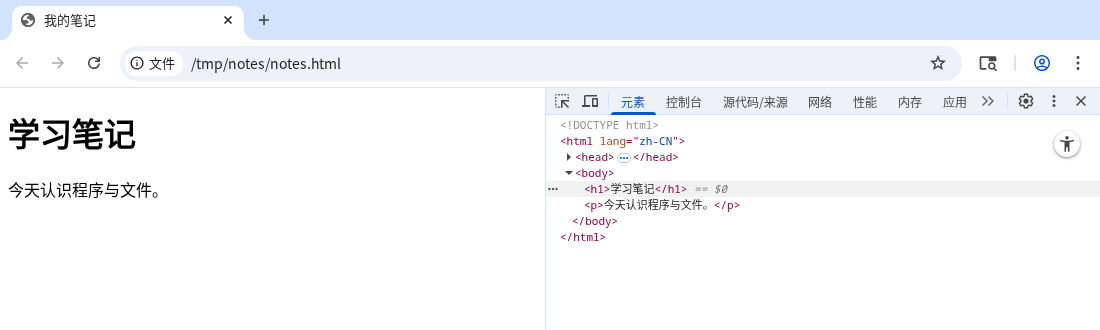
为什么会这样?因为浏览器读完 HTML 文件后,会在内存里建一棵节点树,叫 DOM(文档对象模型,Document Object Model)。你在 Elements 面板里改的只是当前浏览器内存里的 DOM 节点,既没有改写硬盘上的 notes.html,也没有给任何服务器发保存请求。一按刷新,浏览器扔掉内存里的旧 DOM,重新读一遍源文件,刚才改的东西自然就全没了。
| 层级 | 在哪里 | 刷新页面后会怎样 |
|---|---|---|
| HTML 源文件 | 本机硬盘上的 notes.html | 原封不动 |
| DOM 树 | 浏览器运行内存 | 推倒重建,你在 F12 里做的临时修改全部丢失 |
| 服务端数据 | 远端服务器的数据库 | 只有收到合法的写请求并存进数据库后才会改变 |
这也是为什么:
- 按 F12 把页面上的“账户余额:20 元”改成“20000 元”没法真变有钱:你只改了自己屏幕上的显示,服务器数据库里你的余额还是 20 元。
- 但按 F12 却能绕过纯前端限制:如果程序员图省事,只在网页按钮上写了个
disabled属性不让普通用户点,或者只在输入框上写了maxlength="5"限制长度,后端接口却不做检查,那你用 F12 删掉disabled或maxlength,真就能把请求发出去。前端限制只能防君子,真正的权限和数据校验必须在后端做。