

HTTP 协议本身是无状态的(Stateless)。服务器默认不会把前后两次请求关联起来,也不会天然知道某个请求来自哪个用户。
为了维持用户的登录状态,Web 应用通常采用 Cookie-Session 机制:
- 用户提交账号和密码登录成功;
- 服务器在后端内存或数据库中创建一条 Session 记录(关联用户
reader),并生成一个全局唯一的随机令牌,即 Session ID; - 服务器在 HTTP 响应头中告诉浏览器保存 Cookie:
Set-Cookie: biqu_session=随机值; HttpOnly; Path=/; - 浏览器将该 Cookie 保存在本地;
- 之后,浏览器只要访问该站点,就会自动在请求头中附带:
Cookie: biqu_session=随机值; - 服务器从请求中读取 Session ID,再查表确认这是用户
reader的会话,从而允许访问私人书架。
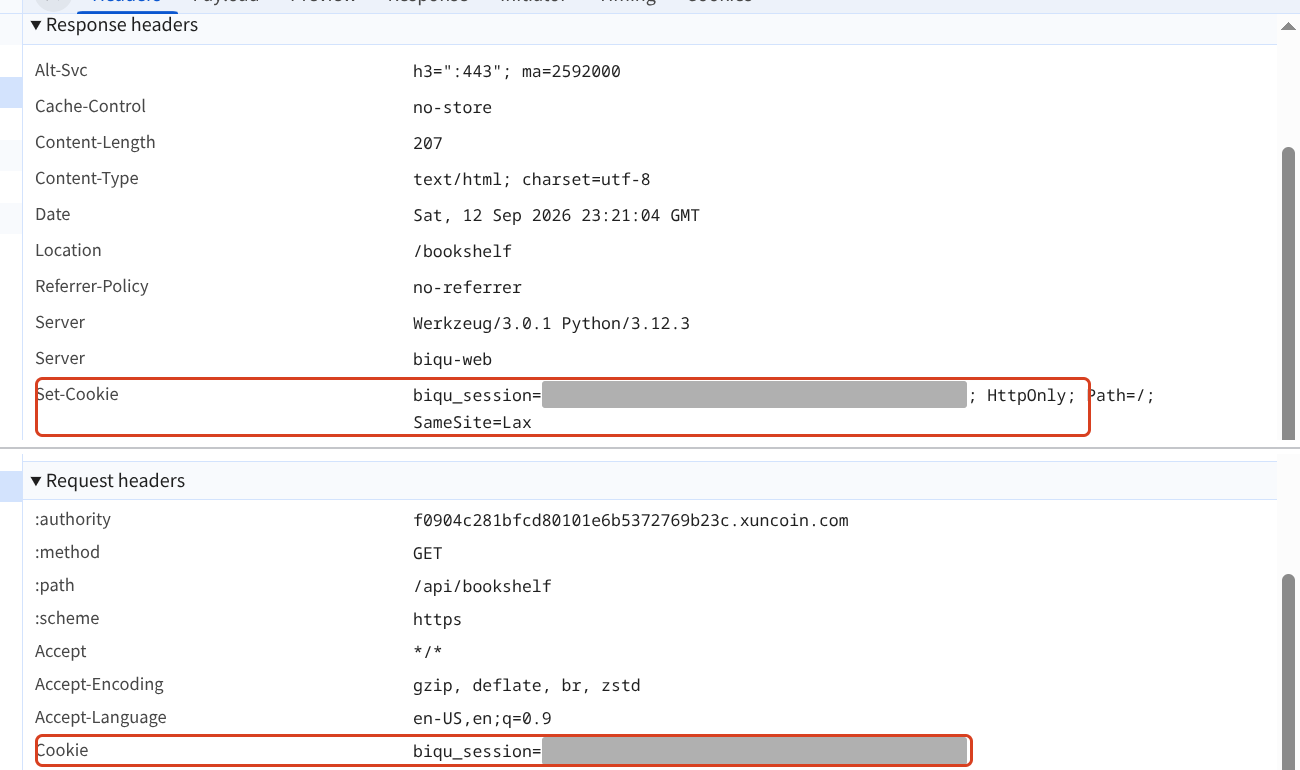
可以把 Session 理解成服务器端保存的登录档案,而 Cookie 只是浏览器携带的“访问凭证”。服务器不是识别浏览器本身,而是识别请求中带回来的 Session ID。
常见 Cookie 安全属性
| Cookie 属性 | 核心安全含义与防护作用 |
|---|---|
HttpOnly | 禁止浏览器端 JavaScript 通过 document.cookie 读取该 Cookie,可降低 XSS 攻击窃取 Session 的风险 |
Secure | 指示浏览器只在 HTTPS 加密连接下发送该 Cookie,避免在明文 Wi-Fi 等环境中被网络窃听 |
SameSite | 可选值为 Strict、Lax、None,用于控制跨站请求时是否自动携带 Cookie,常用于缓解 CSRF 风险 |
Path / Domain | 限制 Cookie 生效的 URL 路径和域名范围,缩小可被带出的访问面 |
用 curl 维护独立的登录会话
浏览器中的登录状态不会自动共享给命令行工具。也就是说,curl 默认不知道浏览器已经登录,必须显式保存和使用 Cookie。命令行中可用 -c 保存 Cookie,用 -b 携带 Cookie:
crow@kali:~$ # 1. 提交账号密码登录,并将服务器下发的 Cookie 保存到 cookies.txt 中
crow@kali:~$ curl -sS -D - -o /dev/null -c cookies.txt -d 'username=reader&password=bookworm' "$target_url/login"

crow@kali:~$ # 2. 携带 cookies.txt 请求受保护的书架接口
crow@kali:~$ curl -sS -b cookies.txt "$target_url/api/bookshelf"
[]
如果省略第一步,curl 发出的请求中就不会包含 Cookie: biqu_session=...,服务器自然无法识别用户身份,书架接口可能返回 401。