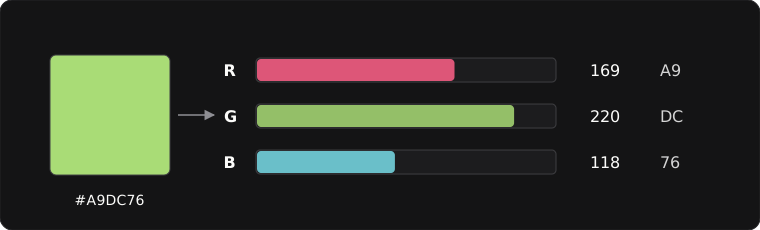

计算机存储的所有文件底层都是字节序列。同一个字节 0x41,按整数解释是 65,按英文字符解释是大写字母 A,在图像数据中则可能表示某个颜色通道的数值。具体含义取决于读取它的软件采用什么格式规则。
字符编码:ASCII、Unicode 与 UTF-8
要把文字存进计算机,就得先规定每个字符对应哪个数字编号,这叫字符编码:
- ASCII:最早期的英文编码表,只占 1 个字节,规定了
0–127共 128 个字符(英文大小写字母、数字、常见标点等)。比如大写字母A是65(十六进制0x41),字符'5'是53(0x35)。 - Unicode:为了装下全世界所有语言的文字和 Emoji,Unicode 给每个字符分配了一个统一的编号(叫码点),比如
A是U+0041,汉字乌是U+4E4C。 - UTF-8:现在最通用的存储方案,用来把 Unicode 编号存成实际的字节。它是变长编码:
- 英文、数字和英文标点占 1 个字节(和 ASCII 一模一样);
- 绝大多数常用汉字占 3 个字节;
- 少数生僻字和 Emoji 占 4 个字节。
| 字符 | Unicode 码点 | UTF-8 字节(十六进制) | 占几个字节 |
|---|---|---|---|
| A | U+0041 | 41 | 1 字节 |
| 乌 | U+4E4C | E4 B9 8C | 3 字节 |
比如一个 UTF-8 文本文件里只写了 A乌 两个字,它在硬盘上存的字节就是 41 E4 B9 8C,一共占 4 个字节。
乱码与换行符
为什么有时候打开别人发的文本文件会看到一堆乱码?通常不是文件坏了,而是存文件时用的编码和打开时用的编码对不上(比如对方用老式 GBK 编码保存,每个汉字占 2 个字节;你的编辑器却按 UTF-8 每 3 个字节切一个字去读,自然就全乱了)。遇到乱码时千万别点保存,换个编码重新打开就行。
另外,平时按回车键换行,在文件里也是实打实占字节的:
- Linux / macOS 用 LF(
0x0A)表示换行,占 1 个字节; - Windows 用 CRLF(
0x0D 0x0A)表示换行,占 2 个字节。
如果在 A乌 后面按了一下回车(按 Linux 的 LF 算,多了个 0A),整个文件的字节就会变成 41 E4 B9 8C 0A。