URL 与连接

访问网上的站点时,浏览器靠 URL(统一资源定位符,Uniform Resource Locator) 找到目标服务器上的资源。

URL 的六个部分

拿下面这个 URL 来说:

https://books.example.com:8443/book?id=1#chapters
URL 中的方案、主机、端口、路径、查询字符串与片段

  1. 方案(Scheme):https,表示走 TLS 加密的 HTTP 协议(明文则是 http)。
  2. 主机(Host):books.example.com,目标服务器的域名或 IP 地址。
  3. 端口(Port)::8443。如果不写端口号,浏览器会自动连默认端口:http 默认 80,https 默认 443。
  4. 路径(Path):/book,服务器上的资源路径或路由入口。
  5. 查询字符串(Query String):?id=1,以 ? 开头、用 & 分隔的 键=值 参数,用来向后端传参。
  6. 片段(Fragment / Hash):#chapters,以 # 开头,用来跳到页面内的某个锚点或控制前端单页路由。

重要

浏览器向服务器发 HTTP 请求时,#chapters 这段片段绝对不会发到网络上。它只在浏览器本地起作用,服务器完全看不到 # 和它后面的内容。
找到端口号

练习

提交答案

题解 Hint

域名解析与 Host 请求头

输完网址回车后,浏览器先通过 DNS(或本机 /etc/hosts)把域名 books.example.com 解析成服务器的 IP 地址,再去连它的 TCP 端口。

但现在一台云服务器(同一个 IP 和 80/443 端口)上往往同时挂着好几个不同域名的网站(这叫基于域名的虚拟主机)。连上同一个 IP 之后,Web 服务器(比如 Nginx)怎么知道你想看哪个网站?全靠读 HTTP 请求头里的 Host: books.example.com。在渗透测试里,有时保持目标 IP 不变,故意把 Host 头改成内网子域名(比如 Host: admin.books.example.com),就能撞出同一台机器上没对外公开的隐藏站点。

网页里的相对路径

写网页时,链接(href)和图片脚本(src)很少每次都把完整域名写全,而是常写相对路径,由浏览器根据当前页面地址自动拼完整:

源码里的相对链接当前页面地址浏览器实际请求的完整 URL
chapter.htmlhttps://books.example/library/index.htmlhttps://books.example/library/chapter.html(同级目录)
/chapter.htmlhttps://books.example/library/index.htmlhttps://books.example/chapter.html(/ 开头代表从网站根目录算起)
../cover.pnghttps://books.example/library/index.htmlhttps://books.example/cover.png(.. 代表退回上一级目录)

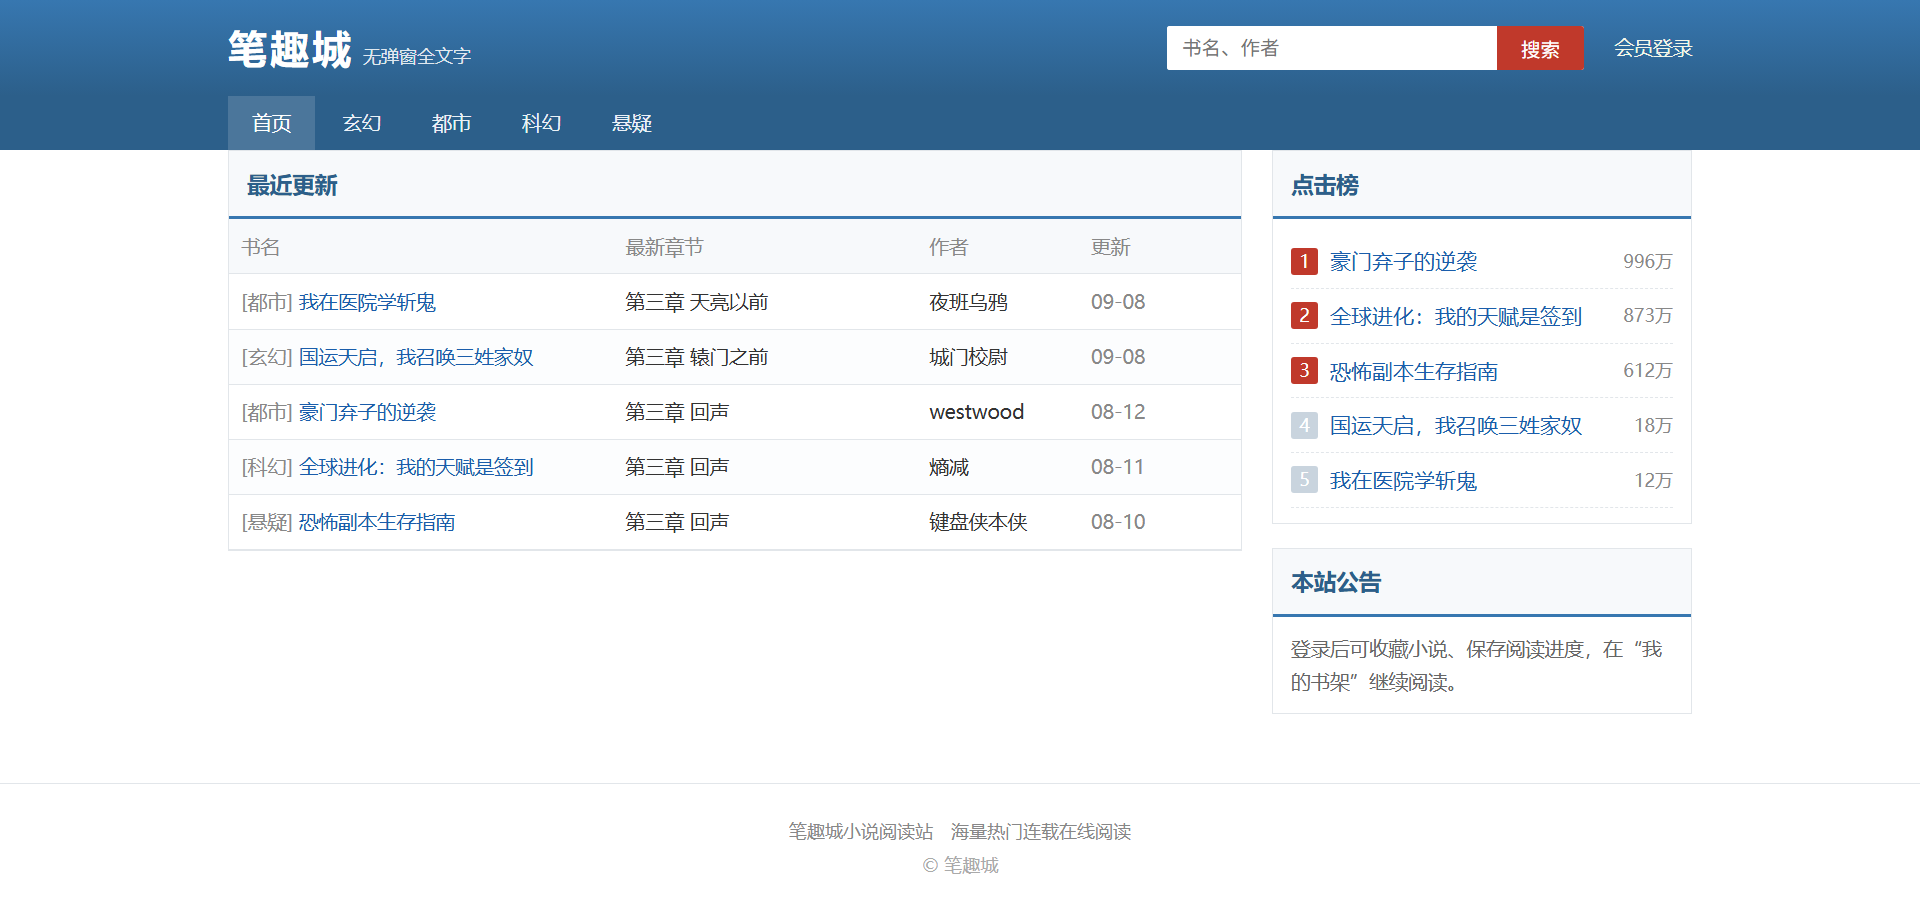
实验站:笔趣城

从下一章开始,我们会拿一个在线小说网站——笔趣城——来练手。后面有动手任务的章节都可以点任务卡上的“启动实验”打开靶机,既能点 TARGET Web 在浏览器里看,也能把地址复制到终端里用 curl 发请求。

笔趣城首页展示小说搜索、分类、书目与会员入口